3D TechCore
Магазин 3D принтеров
Магазин 3D принтеров
Адрес офиса
Написать письмо
Магазин 3D принтеров
4 600 000 ₽


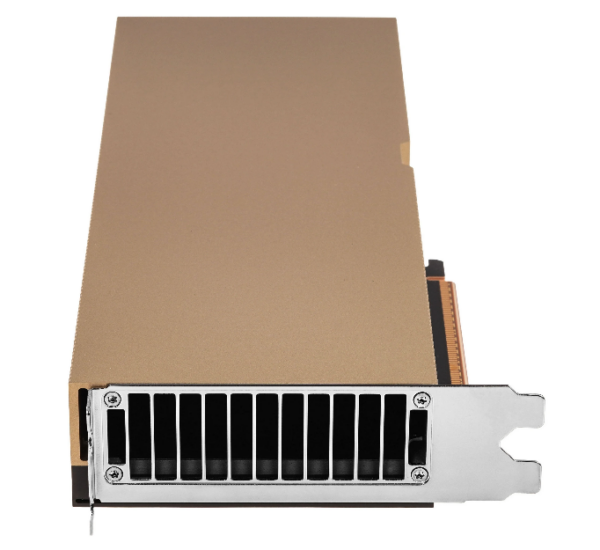
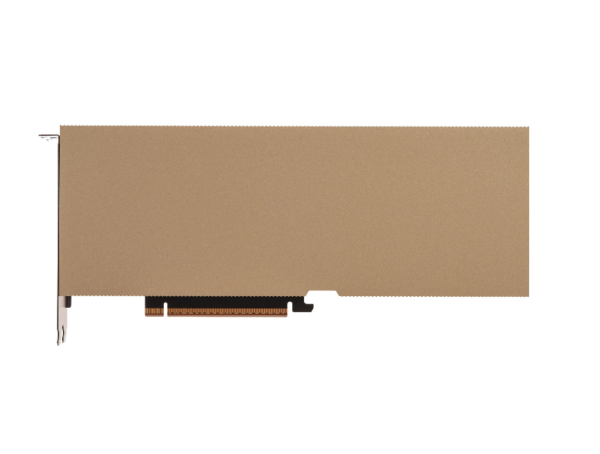
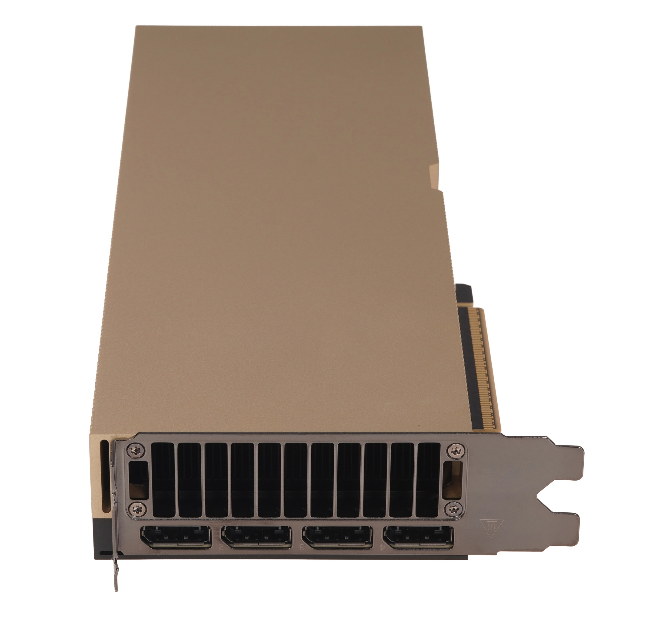
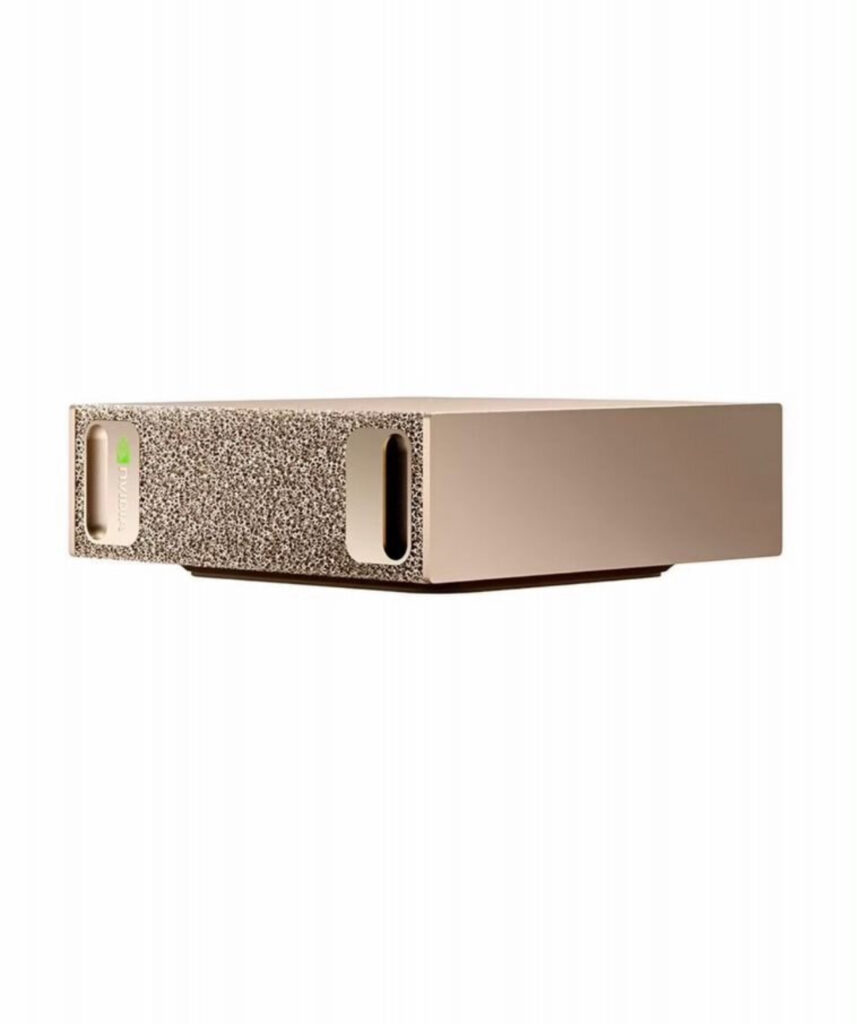
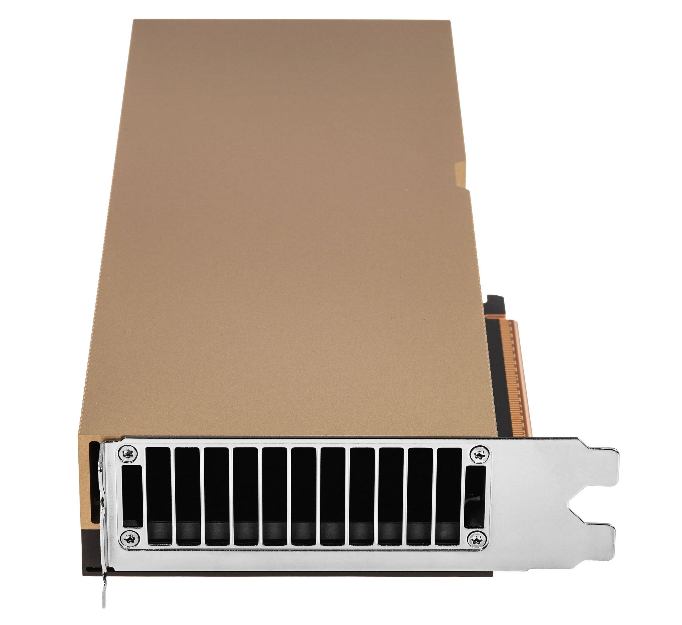
NVIDIA H200 Tensor Core GPU 141GB HBM3e — высокопроизводительный серверный ускоритель на архитектуре NVIDIA Hopper, созданный для искусственного интеллекта, больших языковых моделей (LLM), генеративного AI, машинного и глубокого обучения, высокопроизводительных вычислений (HPC), научного моделирования и обработки больших массивов данных.
H200 стала первым GPU NVIDIA с памятью HBM3e. Ускоритель получил 141 ГБ высокоскоростной памяти с пропускной способностью 4,8 ТБ/с. Большой объём и высокая скорость памяти особенно важны для современных LLM и других AI-нагрузок, где производительность зачастую ограничивается не только вычислительной мощностью GPU, но и объёмом и пропускной способностью памяти.
NVIDIA H200 предназначена прежде всего для серверов, дата-центров, AI-кластеров и HPC-инфраструктуры.
| Характеристика | Значение |
|---|---|
| Модель | NVIDIA H200 Tensor Core GPU |
| Архитектура | NVIDIA Hopper |
| Видеопамять | 141 ГБ |
| Тип памяти | HBM3e |
| Пропускная способность памяти | 4,8 ТБ/с |
| FP64 | 34 TFLOPS |
| FP64 Tensor Core | 67 TFLOPS |
| FP32 | 67 TFLOPS |
| TF32 Tensor Core | до 989 TFLOPS* |
| BFLOAT16 Tensor Core | до 1 979 TFLOPS* |
| FP16 Tensor Core | до 1 979 TFLOPS* |
| FP8 Tensor Core | до 3 958 TFLOPS* |
| INT8 Tensor Core | до 3 958 TOPS* |
| Tensor Cores | 4-е поколение |
| NVLink | до 900 ГБ/с |
| PCI Express | PCIe Gen5, до 128 ГБ/с |
| MIG | до 7 инстансов по 18 ГБ |
| NVDEC | 7 аппаратных декодеров |
| JPEG Decoder | 7 |
| Confidential Computing | Поддерживается |
| Максимальный TDP | до 700 Вт, конфигурируемый |
| Форм-фактор | SXM |
| Серверные платформы | NVIDIA HGX H200 и совместимые NVIDIA-Certified Systems |
| Типичное масштабирование | 4 или 8 GPU |
*Пиковая производительность Tensor Core указана NVIDIA с использованием sparsity.
Главная особенность NVIDIA H200 — 141 ГБ памяти HBM3e с пропускной способностью 4,8 ТБ/с.
По сравнению с H100 это существенное улучшение именно подсистемы памяти. Больший объём позволяет размещать на одном GPU более крупные AI-модели и рабочие наборы данных, а повышенная пропускная способность ускоряет задачи, чувствительные к скорости доступа к памяти.
Для AI это особенно важно при работе с:
В отличие от профессиональных RTX с GDDR7/GDDR6, H200 использует HBM3e — High Bandwidth Memory, разработанную для экстремально высокой пропускной способности.
H200 построена на серверной архитектуре NVIDIA Hopper.
Она была разработана специально для современных AI- и HPC-нагрузок и включает Tensor Cores четвёртого поколения и специализированный Transformer Engine.
Transformer Engine особенно важен для современных нейросетей на архитектуре Transformer, к которым относится большинство популярных больших языковых моделей.
Поддержка FP8 позволяет существенно увеличивать производительность AI-вычислений при использовании совместимого программного обеспечения и подходящей модели.
В режиме FP8 пиковая Tensor Core производительность NVIDIA H200 SXM достигает:
3 958 TFLOPS — около 4 PFLOPS.
Для BFLOAT16 и FP16:
до 1 979 TFLOPS.
Для TF32:
до 989 TFLOPS.
Это делает H200 мощным ускорителем для обучения и инференса современных нейронных сетей.
Одно из основных назначений H200 — работа с Large Language Models.
141 ГБ HBM3e позволяют использовать один GPU для значительно более крупных моделей и рабочих нагрузок, чем GPU с 24–48 ГБ VRAM.
H200 подходит для:
Особенно заметное преимущество H200 может давать в задачах инференса, ограниченных пропускной способностью и объёмом GPU-памяти.
141 ГБ памяти позволяют использовать H200 для крупных моделей, однако необходимо учитывать, что фактические требования к VRAM зависят не только от количества параметров.
На расход памяти влияют:
Поэтому утверждение, что конкретная модель гарантированно помещается в 141 ГБ только на основании количества параметров, некорректно.
В зависимости от квантования и конфигурации один H200 способен обслуживать очень крупные LLM, а несколько H200 позволяют распределять модели между GPU.
H200 SXM поддерживает высокоскоростное соединение NVIDIA NVLink с пропускной способностью до 900 ГБ/с.
NVLink имеет огромное значение в multi-GPU системах.
При обучении или инференсе крупной модели нагрузка может распределяться между несколькими H200. Высокоскоростная связь между GPU уменьшает ограничения, возникающие при интенсивном обмене данными между ускорителями.
Это позволяет создавать мощные системы с несколькими GPU для крупных AI-моделей и HPC.
H200 SXM используется в серверных платформах NVIDIA HGX H200 и совместимых системах партнёров.
Типичные конфигурации включают:
4 × NVIDIA H200
или
8 × NVIDIA H200.
При использовании восьми ускорителей суммарно физически установлено:
1 128 ГБ HBM3e — более 1,1 ТБ GPU-памяти.
Совокупная теоретическая пропускная способность памяти восьми H200 достигает:
38,4 ТБ/с.
При этом важно понимать: память нескольких GPU не превращается автоматически в один универсальный общий пул. Использование суммарного объёма зависит от программного обеспечения и выбранной технологии распределения модели и вычислений.
NVIDIA H200 поддерживает технологию Multi-Instance GPU (MIG).
Для H200 SXM один физический GPU можно разделить вплоть до:
7 MIG-инстансов по 18 ГБ каждый.
Каждый инстанс получает выделенные ресурсы GPU, что позволяет использовать один H200 для обслуживания нескольких независимых вычислительных нагрузок.
MIG особенно полезна:
H200 предназначена не только для нейросетей.
Ускоритель рассчитан на HPC — High Performance Computing и подходит для:
Производительность FP64 H200 SXM составляет 34 TFLOPS, а FP64 Tensor Core — 67 TFLOPS.
Это принципиальное отличие серверного H200 от многих GPU, ориентированных преимущественно на графику или потребительские задачи.
Одно из главных улучшений H200 относительно H100 — память.
NVIDIA H100 SXM:
80 ГБ HBM3 и около 3,35 ТБ/с пропускной способности памяти.
NVIDIA H200 SXM:
141 ГБ HBM3e и 4,8 ТБ/с.
Таким образом, H200 предлагает примерно на 76% больше GPU-памяти, а пропускная способность памяти выросла примерно на 43%.
Благодаря этому H200 особенно эффективна в memory-intensive AI-нагрузках и при инференсе крупных языковых моделей.
При выборе H200 важно учитывать конкретное исполнение.
Поэтому при продаже товара желательно обязательно указывать, какая именно версия предлагается: H200 SXM или H200 NVL PCIe.
NVIDIA H200 не следует рассматривать как замену GeForce RTX или RTX PRO для обычной рабочей станции.
Это специализированный Data Center GPU Accelerator.
H200 создавалась для:
AI-серверов
дата-центров
HPC-кластеров
облачных платформ
LLM-инфраструктуры
корпоративных AI-систем
Для установки H200 SXM необходима специализированная совместимая серверная платформа.
Это не PCIe-видеокарта, которую можно установить в обычный настольный компьютер.
Максимальный TDP NVIDIA H200 SXM составляет до 700 Вт и может конфигурироваться.
Поэтому сервер должен иметь соответствующую систему:
В multi-GPU конфигурациях требования становятся особенно серьёзными. Только восемь GPU при максимальном лимите мощности теоретически могут потреблять до 5,6 кВт, не считая CPU, памяти, накопителей, сетевых адаптеров и остальных компонентов сервера.
NVIDIA H200 поддерживает Confidential Computing.
Технология предназначена для повышения защищённости вычислительных нагрузок и данных, что особенно актуально при использовании GPU в корпоративной и облачной инфраструктуре.
Large Language Models — инференс и обучение больших языковых моделей.
Generative AI — генерация текста, изображений, видео и мультимодального контента.
Machine Learning — обучение и эксплуатация моделей машинного обучения.
Deep Learning — крупные нейронные сети и распределённое обучение.
AI Inference — высокопроизводительное обслуживание AI-моделей.
Fine-Tuning — дообучение существующих моделей.
HPC — высокопроизводительные научные вычисления.
Scientific Computing — физика, химия, медицина, биоинформатика и другие научные направления.
AI Cloud — построение облачной GPU-инфраструктуры.
Enterprise AI — корпоративные AI-сервисы и локальная AI-инфраструктура.
141 ГБ HBM3e — большой объём высокоскоростной памяти для LLM, AI и HPC.
4,8 ТБ/с — чрезвычайно высокая пропускная способность памяти.
Архитектура NVIDIA Hopper — серверная архитектура для AI и HPC.
Tensor Cores 4-го поколения — аппаратное ускорение современных AI-вычислений.
Transformer Engine — ускорение моделей на базе архитектуры Transformer.
До 3 958 TFLOPS FP8 — высокая пиковая Tensor Core производительность H200 SXM.
NVLink до 900 ГБ/с — высокоскоростное соединение GPU в multi-GPU системах.
MIG — возможность разделить физический GPU на несколько независимых вычислительных инстансов.
Confidential Computing — поддержка защищённых вычислений.
До 700 Вт TDP — высокий энергетический лимит для серверных вычислительных нагрузок.
NVIDIA H200 Tensor Core GPU 141GB HBM3e SXM
141 ГБ HBM3e • 4,8 ТБ/с • NVIDIA Hopper • 34 TFLOPS FP64 • 67 TFLOPS FP32 • до 989 TFLOPS TF32 Tensor Core • до 1 979 TFLOPS FP16/BF16 Tensor Core • до 3 958 TFLOPS FP8 • NVLink 900 ГБ/с • PCIe Gen5 • MIG до 7 × 18 ГБ • до 700 Вт • SXM
NVIDIA H200 141GB HBM3e — профессиональный серверный AI-ускоритель для построения высокопроизводительной инфраструктуры искусственного интеллекта. Огромный объём HBM3e, пропускная способность 4,8 ТБ/с и архитектура Hopper делают H200 мощным решением для LLM, генеративного AI, машинного обучения, инференса и HPC.
Ускоритель предназначен для специализированных серверных платформ и дата-центров, где требуются высокая производительность, масштабирование на несколько GPU и возможность работы с крупными AI-моделями и наборами данных.